



Budowa platformy danych: 7 kluczowych błędów architektonicznych, których już nigdy byśmy nie popełnili
⏱️ Czas czytania: ok. 8 minut
Nowoczesna budowa platformy danych to nie jednorazowy projekt IT, ale ciągły proces, który musi elastycznie wspierać rozwój biznesu. Niestety, w praktyce inżynierskiej granica między elastyczną architekturą a kosztownym chaosem bywa niezwykle cienka. W Alterdata zrealizowaliśmy ponad 60 dedykowanych platform danych dla firm z sektora mid-market oraz digital natives. Zamiast czystej teorii i powielania marketingowych haseł, dzielimy się twardymi wnioskami z naszych wdrożeń.
W niniejszym artykule - będącym kontynuacją naszego cyklu o strategicznym rozwoju środowisk danych – przedstawiamy najczęstsze błędy architektoniczne, których dziś za wszelką cenę byśmy unikali. Poznaj lekcje wynikające bezpośrednio z projektów produkcyjnych.
1. Overengineering i budowanie „na zapas”
Jednym z najczęstszych grzechów na wczesnym etapie rozwoju jest projektowanie zbyt skomplikowanych struktur na zapas. Zamiast skupić się na najszybszym dostarczeniu wartości biznesowej (Time-to-Value), zespoły architektoniczne ulegają pokusie tworzenia systemów przeznaczonych dla obciążeń skrajnie wielkich zbiorów danych (Big Data), zanim organizacja w ogóle ich potrzebuje.
Nadmiernie rozbudowana architektura na starcie może oznaczać wyższe koszty infrastruktury i utrzymania, trudniejszy onboarding nowych inżynierów oraz większą złożoność procesów. Z perspektywy czasu wiemy, że architektura powinna rozwijać się ewolucyjnie, wraz ze zmieniającymi się potrzebami biznesowymi. W wielu przypadkach dobrym rozwiązaniem jest wykorzystanie sprawdzonych technologii analitycznych, takich jak Google BigQuery, z jasno określonym podziałem na warstwy danych. Pozwala to budować solidne fundamenty platformy bez wdrażania na starcie niepotrzebnych komponentów.
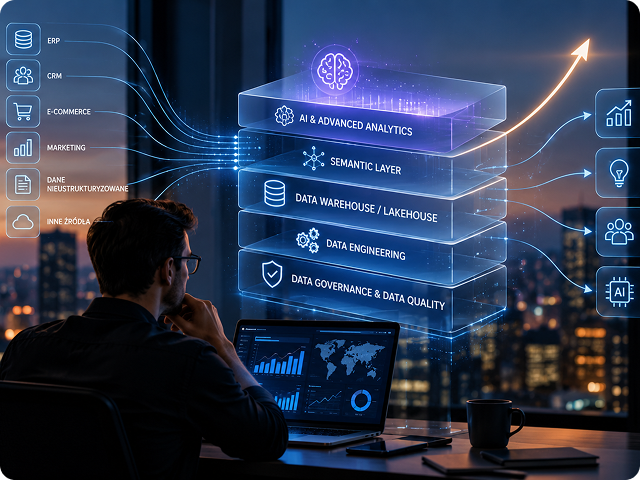
W praktyce oznacza to, że nie każda organizacja musi od razu inwestować w rozbudowany ekosystem Data Lakehouse czy dodatkowe narzędzia do przetwarzania danych. Często wystarczy prosta hurtownia danych, integrująca najważniejsze źródła i umożliwiająca spójne raportowanie. Rozbudowa architektury powinna wynikać z konkretnych potrzeb, takich jak rosnąca skala przetwarzania, wymagania dotyczące analizy w czasie rzeczywistym czy konieczność obsługi bardziej złożonych procesów analitycznych i AI.
2. Streaming wszędzie, nawet tam, gdzie wystarczy Batch
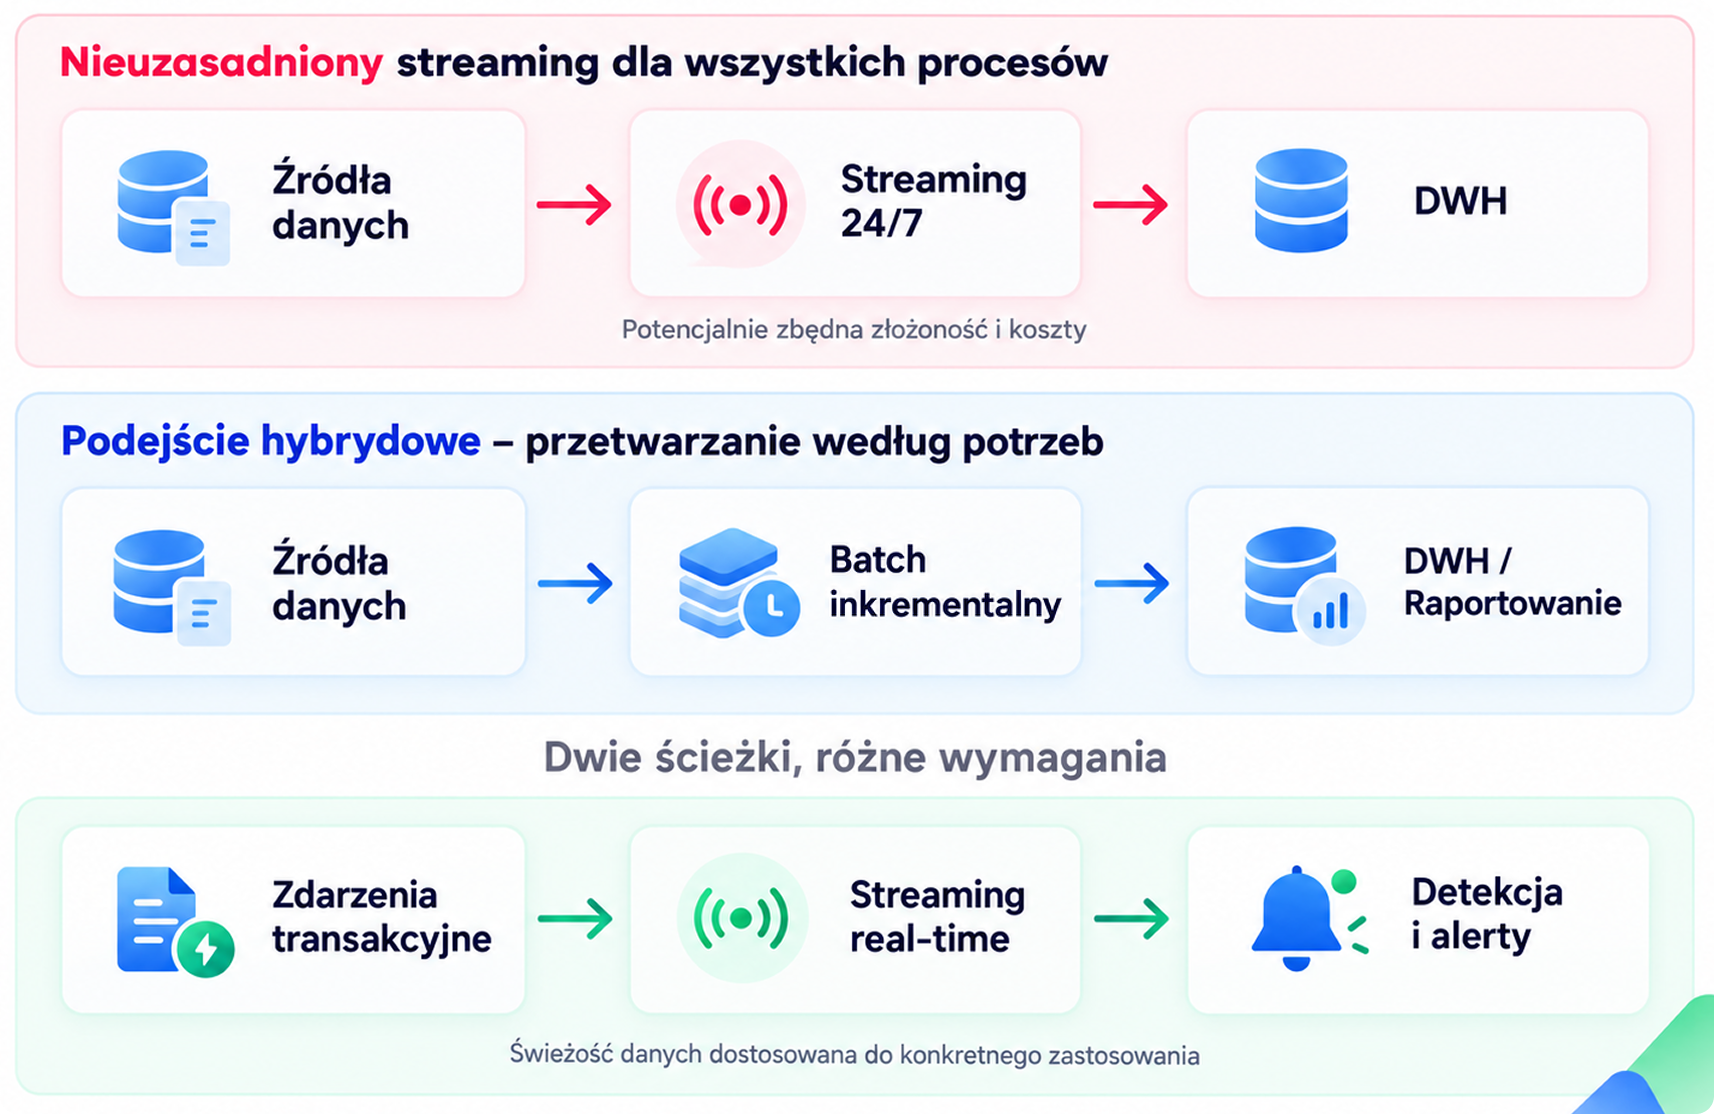
Przetwarzanie danych w czasie rzeczywistym (Real-time Streaming) brzmi atrakcyjnie w prezentacjach biznesowych. Jednak zastąpienie klasycznego przetwarzania wsadowego (Batch) pełnym przetwarzaniem strumieniowym może znacząco zwiększyć złożoność architektury oraz koszty jej utrzymania. Ciągłe przetwarzanie danych wymaga odpowiedniego zarządzania przepływem zdarzeń, obsługi błędów i monitorowania procesów. Dlatego wybór odpowiedniego podejścia powinien wynikać z rzeczywistych potrzeb biznesowych, wymaganej świeżości danych i oczekiwanego czasu reakcji systemu, a nie z technologicznej mody.
W praktyce biznesowej dla wielu wskaźników KPI i raportów zarządczych wystarczająca jest aktualizacja danych co kilka godzin lub nawet raz dziennie. W takich przypadkach przetwarzanie wsadowe, również w modelu inkrementalnym, może być prostszym i bardziej ekonomicznym rozwiązaniem. Streaming warto wdrażać tam, gdzie opóźnienie w dostępie do informacji rzeczywiście wpływa na działanie organizacji – na przykład przy wykrywaniu nadużyć finansowych, monitorowaniu procesów operacyjnych czy reagowaniu na zdarzenia w czasie rzeczywistym. Nowoczesne platformy, takie jak Google BigQuery, pozwalają łączyć różne sposoby dostarczania danych w ramach jednego środowiska analitycznego. Dzięki temu organizacja może dostosować częstotliwość przetwarzania do potrzeb konkretnych procesów, zamiast budować kosztowną architekturę strumieniową dla całego ekosystemu.
3. Nadmierna biurokracja w Data Governance
Data Governance powinno być integralną częścią platformy danych już od początku jej budowy. Jasno określone odpowiedzialności, zasady dostępu, podstawowe reguły jakości oraz dokumentacja kluczowych zasobów pomagają zapewnić bezpieczeństwo i spójność informacji. Nie oznacza to jednak konieczności wdrażania od razu rozbudowanych procedur, wieloetapowych procesów akceptacji czy szczegółowego katalogowania każdego zbioru danych. Zakres tych działań powinien odpowiadać skali platformy, jej złożoności oraz rzeczywistym potrzebom organizacji.
Nadmierna formalizacja procesów może przynieść efekt odwrotny do zamierzonego, utrudniając codzienną pracę z danymi. Najczęstsze konsekwencje to:
- Spadek zwinności: Analitycy i inżynierowie poświęcają coraz więcej czasu na formalności i uzyskiwanie zgód, zamiast koncentrować się na dostarczaniu wartości biznesowej.
- Powstawanie „szarej strefy”: Zbyt skomplikowane procedury mogą skłaniać zespoły biznesowe do tworzenia własnych arkuszy kalkulacyjnych i niezależnych zestawień poza centralną platformą danych. Zwiększa to ryzyko niespójności informacji, rozbieżnych definicji wskaźników oraz udostępniania danych poza przyjętymi zasadami kontroli dostępu.
- Nieefektywne wykorzystanie zasobów: Szczegółowe dokumentowanie każdego tymczasowego zbioru danych, który wkrótce zmieni strukturę lub przestanie istnieć, generuje dodatkową pracę bez proporcjonalnych korzyści.
Wraz z rozwojem platformy warto stopniowo rozszerzać Data Governance o bardziej zaawansowane mechanizmy katalogowania, zarządzania metadanymi, monitorowania jakości czy śledzenia pochodzenia danych. Narzędzia takie jak Google Cloud Knowledge Catalog mogą wspierać te działania i ograniczać potrzebę ręcznego zarządzania informacjami o zasobach. Najważniejsze jest jednak to, aby rozwój Data Governance wynikał z konkretnych potrzeb, a wdrażane mechanizmy ułatwiały pracę z danymi, zamiast tworzyć kolejne bariery organizacyjne.
4. Brak kontroli nad kosztami platformy danych
Model Pay-As-You-Go pozwala elastycznie korzystać z zasobów chmurowych, ale bez odpowiedniego nadzoru może prowadzić do nieprzewidzianych wydatków. Nieoptymalne zapytania, nadmierne przetwarzanie tych samych danych, niepotrzebnie uruchomione zasoby czy niewłaściwie dobrany model rozliczeniowy mogą sprawić, że koszty utrzymania platformy będą rosły szybciej niż jej wartość biznesowa.
Dlatego kontrolę kosztów warto uwzględnić już na etapie projektowania architektury. Podstawą powinno być ustalenie budżetów dla poszczególnych projektów lub środowisk oraz skonfigurowanie alertów informujących o zbliżaniu się do określonych progów wydatków. Narzędzia dostępne w Google Cloud Billing pozwalają monitorować wykorzystanie budżetu i reagować na niepokojące wzrosty kosztów. Równie istotna jest regularna analiza zużycia zasobów, optymalizacja zapytań i procesów przetwarzania oraz świadomy wybór modeli rozliczeniowych.
Zarządzanie kosztami nie powinno być jednorazowym działaniem podejmowanym dopiero po otrzymaniu wysokiej faktury. To stały element utrzymania i rozwoju platformy, który pozwala zachować równowagę między wydajnością, skalowalnością a opłacalnością całego rozwiązania.
5. Nieświadome uzależnienie od dostawcy technologii (Vendor Lock-in)
Wybór dostawcy chmury i technologii wykorzystywanych do budowy platformy danych to decyzja, która wpływa na możliwości jej dalszego rozwoju. Korzystanie z usług natywnych, takich jak Google BigQuery, nie jest samo w sobie błędem. Wręcz przeciwnie – pozwala ograniczyć złożoność infrastruktury, przyspieszyć wdrożenie i wykorzystać gotowe mechanizmy skalowania. Problem pojawia się wtedy, gdy organizacja buduje kolejne zależności technologiczne bez świadomości ich długoterminowych konsekwencji.
Im więcej kluczowych procesów opiera się na rozwiązaniach specyficznych dla jednego dostawcy, tym trudniejsza i bardziej kosztowna może okazać się ich późniejsza migracja lub integracja z innymi środowiskami. Dlatego już na etapie projektowania warto świadomie oceniać, które elementy architektury mogą być silnie powiązane z wybraną platformą, a gdzie uzasadnione jest wykorzystanie otwartych standardów, popularnych formatów danych czy rozwiązań umożliwiających ponowne wykorzystanie kodu.
Celem nie powinno być całkowite wyeliminowanie Vendor Lock-in za wszelką cenę. Takie podejście często prowadzi do niepotrzebnego komplikowania architektury i rezygnacji z korzyści oferowanych przez usługi natywne. Znacznie ważniejsze jest świadome zarządzanie zależnościami, dokumentowanie kluczowych procesów oraz zachowanie możliwości rozwoju platformy bez konieczności przebudowy całego środowiska przy każdej zmianie technologicznej.
6. Brak jasno określonej odpowiedzialności za dane
Nawet najlepiej zaprojektowana platforma danych może szybko stracić na wiarygodności, jeśli w organizacji zabraknie jasnego podziału odpowiedzialności za jakość i utrzymanie danych źródłowych. Przekazanie całej odpowiedzialności centralnemu zespołowi inżynierów danych jest pułapką – inżynierowie odpowiadają za techniczne aspekty przetwarzania danych, ale to właściciele systemów źródłowych i zespoły biznesowe najlepiej rozumieją ich pochodzenie, znaczenie oraz sposób wykorzystania.
Już na początku budowy platformy warto ustalić, kto odpowiada za poszczególne źródła danych, ich jakość oraz informowanie o planowanych zmianach. Wraz z rozwojem środowiska, rosnącą liczbą integracji i zespołów korzystających z danych, same ustalenia organizacyjne mogą jednak przestać wystarczać. Zmiany w strukturze lub znaczeniu danych źródłowych, wprowadzane bez wiedzy zespołu odpowiedzialnego za platformę, mogą prowadzić do awarii potoków przetwarzania, błędów transformacji i nieprawidłowych raportów.
W bardziej rozbudowanych środowiskach warto więc rozważyć wdrożenie kontraktów danych (Data Contracts), które formalizują wymagania dotyczące struktury, jakości i dostępności danych oraz zasady komunikowania zmian. Nie muszą one obejmować od razu wszystkich źródeł – dobrym podejściem jest rozpoczęcie od integracji o największym znaczeniu biznesowym. Równie ważne pozostaje budowanie kultury odpowiedzialności, w której właściciele systemów źródłowych traktują udostępniane dane jako produkt, dbając o ich jakość i przewidywalność dla pozostałych użytkowników platformy.
7. Wdrażanie AI bez uporządkowanych fundamentów danych
Szybki rozwój sztucznej inteligencji skłania wiele firm do wdrażania agentów AI i analityki konwersacyjnej, zanim odpowiednio przygotują swoje środowiska danych. Tymczasem brak spójnych definicji biznesowych, odpowiedniej jakości danych i kontekstu dla modeli może prowadzić do błędnych analiz oraz niewiarygodnych odpowiedzi. AI potrafi znacząco przyspieszyć pracę z informacjami, ale samo w sobie nie rozwiązuje problemów związanych z ich jakością i interpretacją.
Przed wdrożeniem AI wykorzystującego dane organizacji warto zadbać o trzy kluczowe elementy:
- Spójna warstwa semantyczna: Jednoznacznie zdefiniowane wskaźniki i pojęcia biznesowe pozwalają modelom AI prawidłowo interpretować dane oraz ograniczają ryzyko niespójnych odpowiedzi.
- Kontrola jakości danych: Automatyczne testy, walidacja schematów oraz monitorowanie kompletności i aktualności informacji pozwalają ograniczać błędy na kolejnych etapach przetwarzania. Dane wykorzystywane przez rozwiązania AI powinny być odpowiednio przygotowane i zweryfikowane pod kątem konkretnego zastosowania.
- Kontekst biznesowy dla modeli: Opisy tabel i kolumn, słowniki pojęć biznesowych oraz zweryfikowane zapytania pomagają agentom AI prawidłowo interpretować informacje. W połączeniu z dostępem do odpowiednich źródeł danych pozwala to lepiej osadzać generowane odpowiedzi w faktach (grounding) i ograniczać ryzyko błędnej interpretacji.
Podsumowanie i dalsze kroki
Przemyślana budowa platformy danych nie polega na wdrażaniu jak największej liczby technologii, ale na doborze rozwiązań odpowiadających rzeczywistym potrzebom organizacji. Unikanie nadmiernej złożoności, kontrola kosztów, jasny podział odpowiedzialności i odpowiednie przygotowanie danych pozwalają budować środowiska, które wspierają rozwój biznesu oraz przyszłe wdrożenia AI.
Planujesz rozbudowę lub modernizację architektury danych w swojej firmie? Skonsultuj się z ekspertami Alterdata, aby omówić potrzeby twojej firmy i umówić bezpłatną konsultację. Skorzystaj z doświadczenia zespołu, który zrealizował ponad 60 udanych projektów analitycznych i chmurowych.